
Z.ai12 张图 · 首次出现 2026年4月 · 最新 2026年4月10日
GLM-5.1 跑分和性能,一图看懂
我们追踪到的所有包含 GLM-5.1 的图,既有实验室官方发布,也有大家信任的第三方榜单,并附上每张图的传播数据。
图表12
总浏览259.3万
官方2
第三方10
最新2026年4月
GLM-5.1 官方跑分表
数字来自 huggingface.co 以文字发布的表格(Benchmark,读取于2026年5月13日)。每格是一项评测,高亮的是 GLM-5.1。 来源: huggingface.co.
查看数字
| HLE | Gemini 3.1 Pro 45, GPT-5.4 39.8, Claude Opus 4.6 36.7, Kimi K2.5 31.5, GLM-5.1 31, GLM-5 30.5, Qwen3.6-Plus 28.8, Minimax M2.7 28, DeepSeek-V3.2 25.1 |
|---|---|
| HLE (w/ Tools) | Claude Opus 4.6 53.1, GLM-5.1 52.3, GPT-5.4 52.1, Kimi K2.5 51.8, Gemini 3.1 Pro 51.4, Qwen3.6-Plus 50.6, GLM-5 50.4, DeepSeek-V3.2 40.8 |
| AIME 2026 | GPT-5.4 98.7, Gemini 3.1 Pro 98.2, Claude Opus 4.6 95.6, GLM-5 95.4, GLM-5.1 95.3, Qwen3.6-Plus 95.1, DeepSeek-V3.2 95.1, Kimi K2.5 94.5, Minimax M2.7 89.8 |
| HMMT Nov. 2025 | GLM-5 96.9, Claude Opus 4.6 96.3, GPT-5.4 95.8, Gemini 3.1 Pro 94.8, Qwen3.6-Plus 94.6, GLM-5.1 94, Kimi K2.5 91.1, DeepSeek-V3.2 90.2, Minimax M2.7 81 |
| HMMT Feb. 2026 | GPT-5.4 91.8, Qwen3.6-Plus 87.8, Gemini 3.1 Pro 87.3, Claude Opus 4.6 84.3, GLM-5 82.8, GLM-5.1 82.6, Kimi K2.5 81.3, DeepSeek-V3.2 79.9, Minimax M2.7 72.7 |
| IMOAnswerBench | GPT-5.4 91.4, GLM-5.1 83.8, Qwen3.6-Plus 83.8, GLM-5 82.5, Kimi K2.5 81.8, Gemini 3.1 Pro 81, DeepSeek-V3.2 78.3, Claude Opus 4.6 75.3, Minimax M2.7 66.3 |
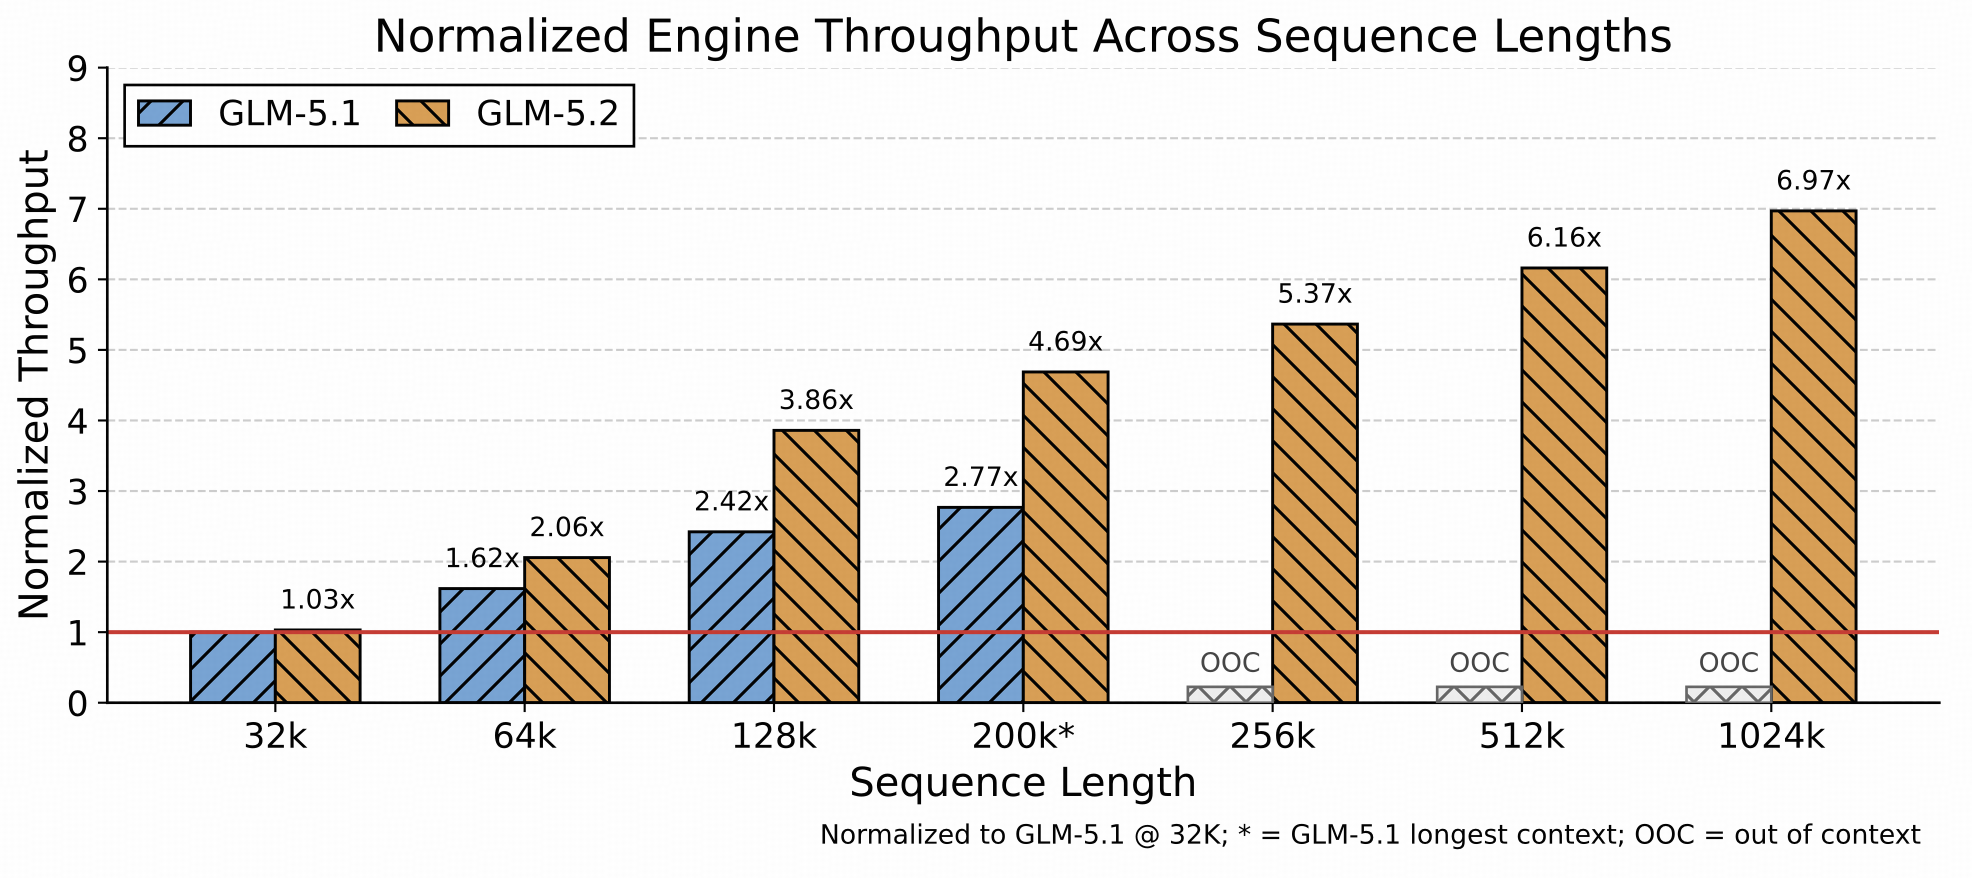
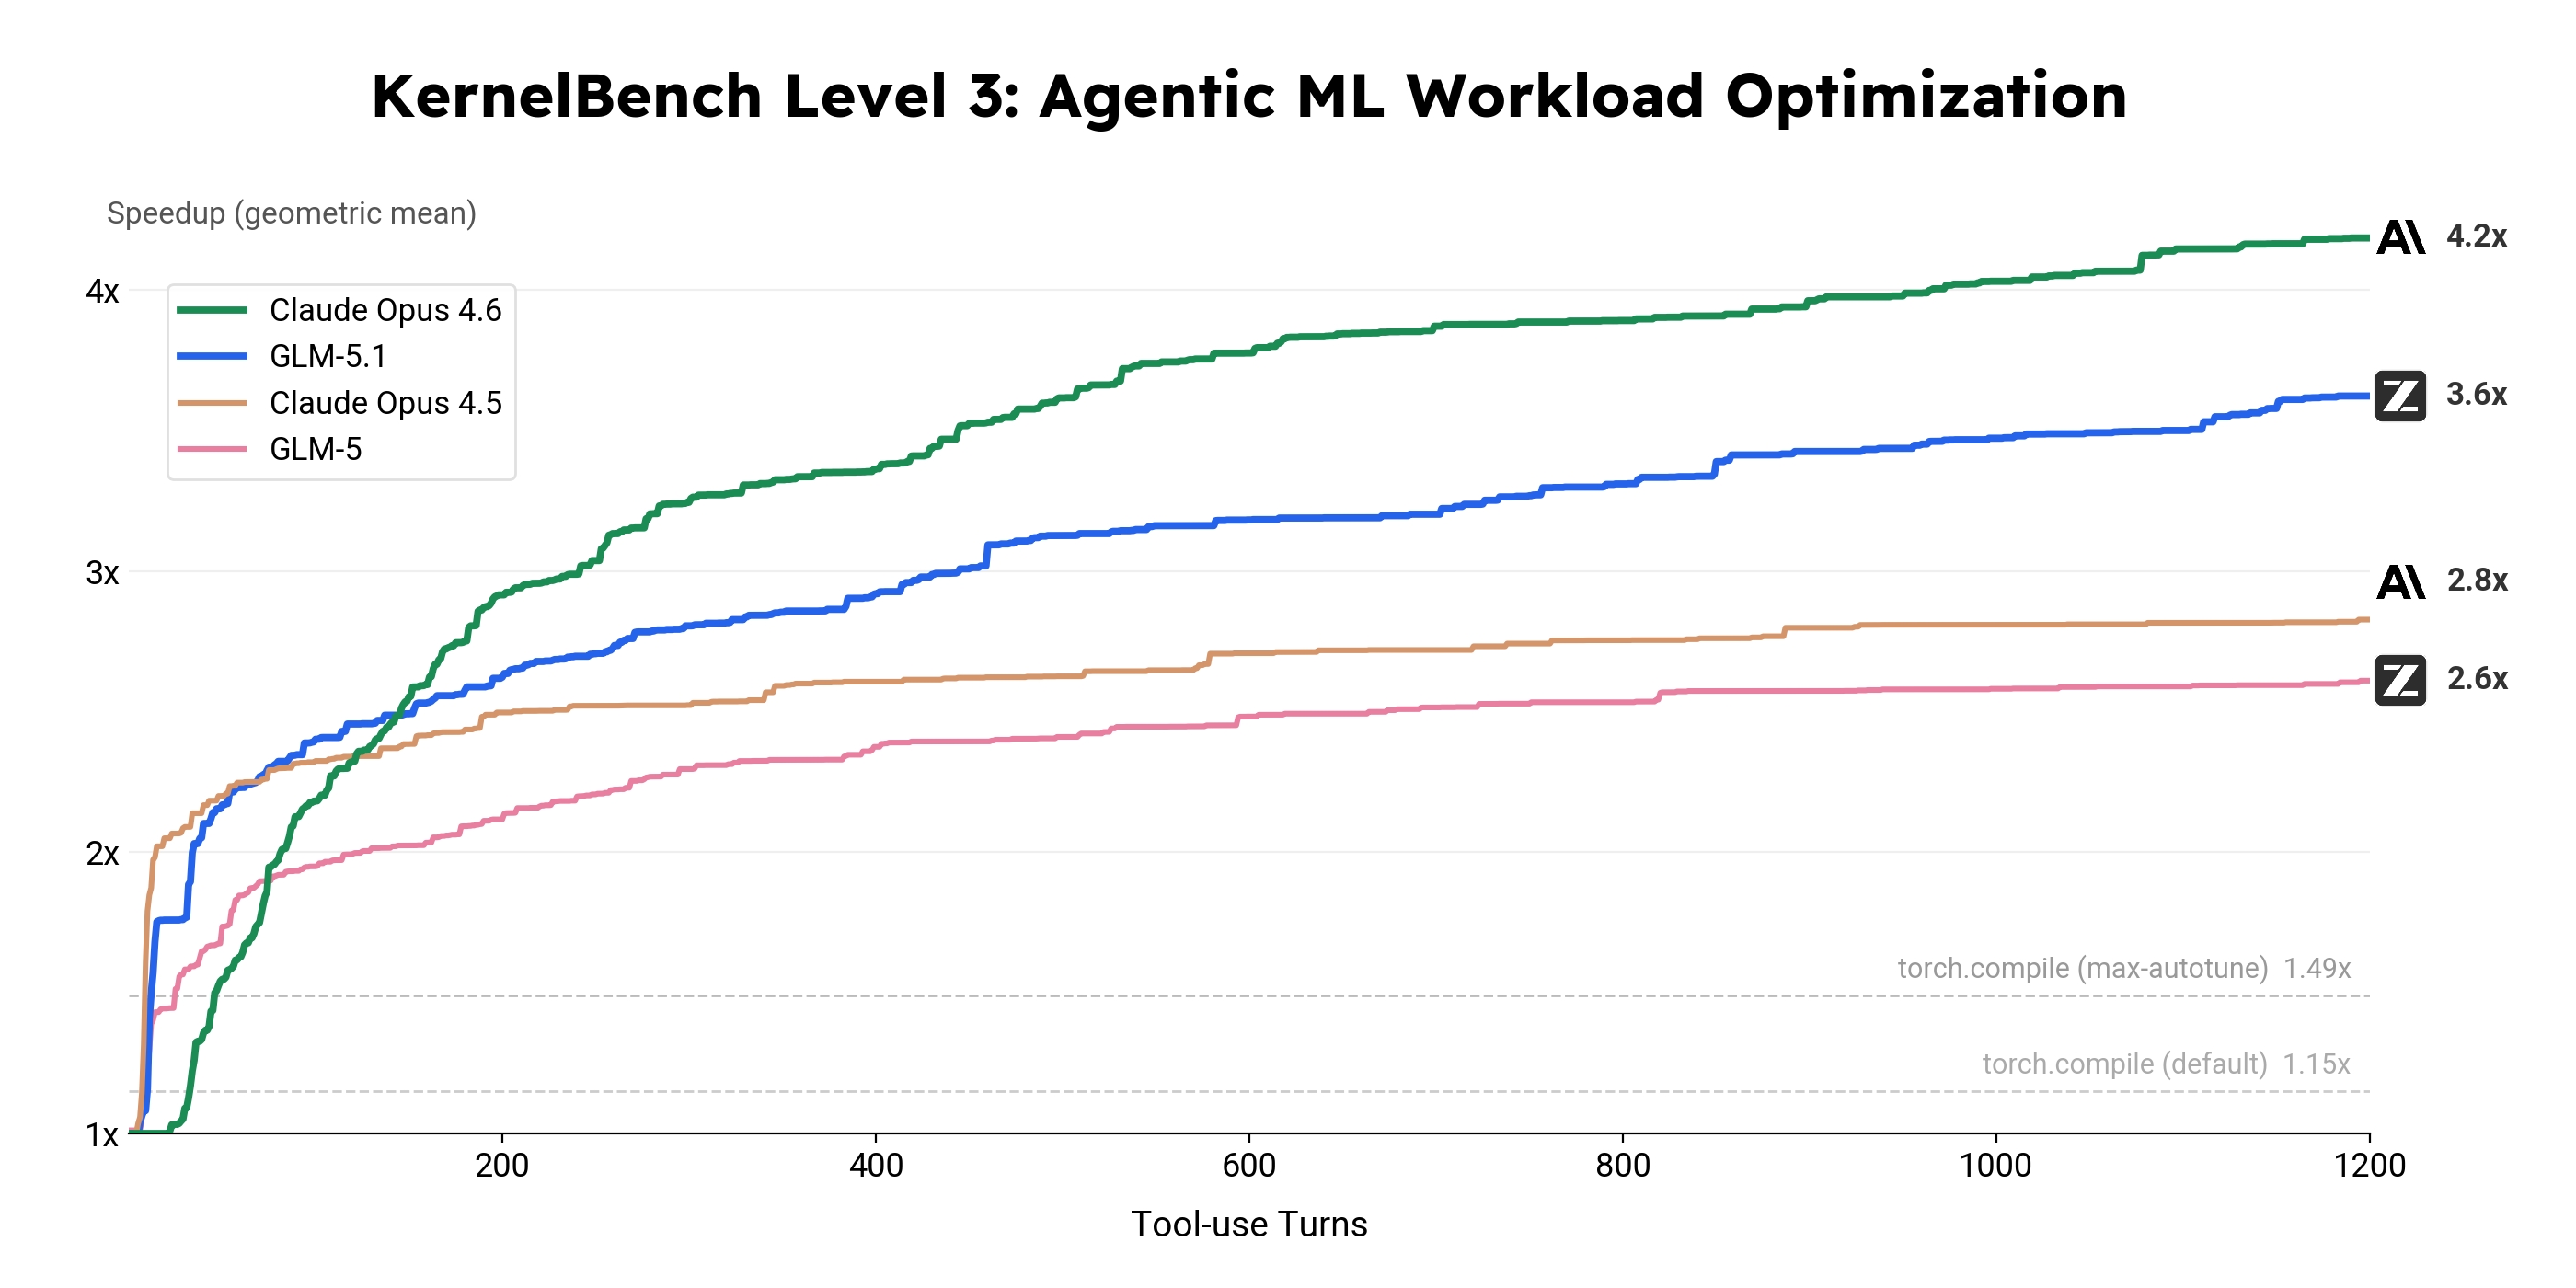
Z.ai发布的官方图
按原样收录自 X、Hugging Face、GitHub 和官方博客,点击打开我们为这张图做的页面。
来自评测榜单和其他发布者


更多以 GLM-5.1 为主角的图
评测榜单、其他实验室和研究者发布的图,点击打开我们为这张图做的页面。


做成你的
你的数字,放进和原图一样的图里。
从 Z.ai 的「Coding Performance SWE-Bench Pro Evaluation」的真实数字开始。发布前请把每个数字换成你的。一步一步做一张这样的图
相似度 7.7 / 10。免费图片带一行小字 “Made with ViralChart”,别人就是通过这一行找到我们的。
常见问题
GLM-5.1 表现怎么样?
我们收录了 6 张包含 GLM-5.1 的图,发布于2026年4月到2026年4月。浏览最多的是 Arena 的「GLM-5.1代码竞技场排名」,494,078 浏览。
GLM-5.1 和 GLM-5 哪个更好?
有 4 张图把它们放在一起比较。谁赢取决于具体评测,每张图都写明了测试项目和发布者。
谁在发 GLM-5.1 的跑分图?
Arena, Artificial Analysis, Z.ai, @Alibaba_Qwen, @arena